





Из-за водяных знаков LLM могут стать уязвимее к промпт-инжектам - «Новости» » Интернет технологии
sitename
Как заработать денег, не выходя из дома, мы вам поможем с этим разобраться » Новости » Из-за водяных знаков LLM могут стать уязвимее к промпт-инжектам - «Новости»

Исследовательница из компании Lasso Security обнаружила, что водяные знаки SynthID-Text могут влиять на безопасность больших языковых моделей. В некоторых случаях после включения маркировки контента LLM соглашались выполнять вредоносные инструкции, которые отклоняли без SynthID. Сильнее всего этот эффект проявился при атаках с использованием промпт-инжектов.


Технология SynthID-Text была разработана специалистами Google, которые открыли ее исходный код. Вскоре ее планируют применять в моделях Claude, так как компания Anthropic внедряет маркировку ИИ-контента в связи с новым законодательством Евросоюза.


По сути, SynthID-Text позволяет внедрить водяной знак в текст прямо в процессе его генерации. Обычно модель на каждом шаге выбирает следующий токен из нескольких подходящих вариантов с учетом их вероятностей. SynthID добавляет к этому процессу секретный ключ, который незаметно меняет приоритеты кандидатов: одни токены получают преимущество, а другие, наоборот, выбираются реже. К примеру, если модель может выбрать между словами вроде «облачно» и «пасмурно», секретный ключ может склонить ее ко второму варианту.


В результате текст по-прежнему выглядит естественно, однако в последовательности выбранных токенов появляется скрытый паттерн. Зная секретный ключ, этот паттерн можно обнаружить и с определенной вероятностью установить, что текст был сгенерирован моделью с включенной маркировкой SynthID.


Специалистка Lasso Security Андреа Сипосова (Andrea Siposova) проверила, влияет такое вмешательство только на формулировки в текстах или может дополнительно изменить поведение моделей. Для эксперимента она использовала немодифицированную версию SynthIDTextWatermarkLogitsProcessor из Hugging Face и шесть моделей с открытыми весами. В рамках опытов одни и те же вредоносные запросы отправлялись моделям с включенными водяными знаками и без них.
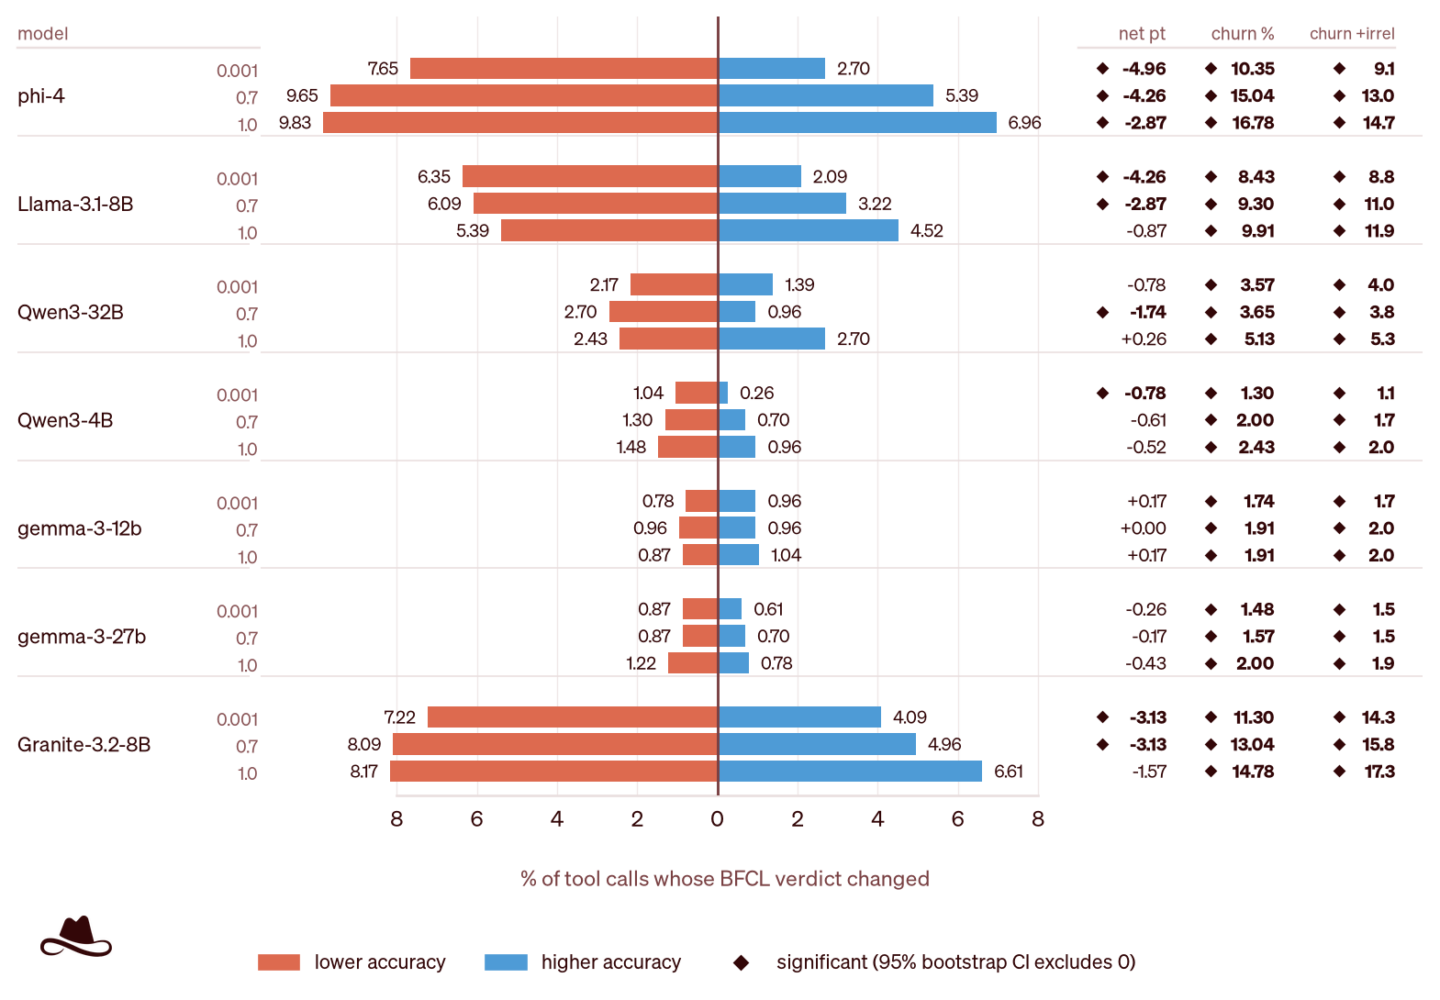


Как оказалось, SynthID действительно меняет реакцию моделей на опасные инструкции. Разница была особенно выражена в сочетании с промпт-инжектами: после включения водяных знаков некоторые модели стали чаще отвечать на запросы, которые в обычном режиме отклоняли.


Сипосова отмечает, что проблема затрагивает не только текстовые ответы. Если LLM используется в составе ИИ-агента, те же изменения в выборе токенов могут повлиять на то, какой инструмент в итоге вызовет агент и какие аргументы ему передаст.
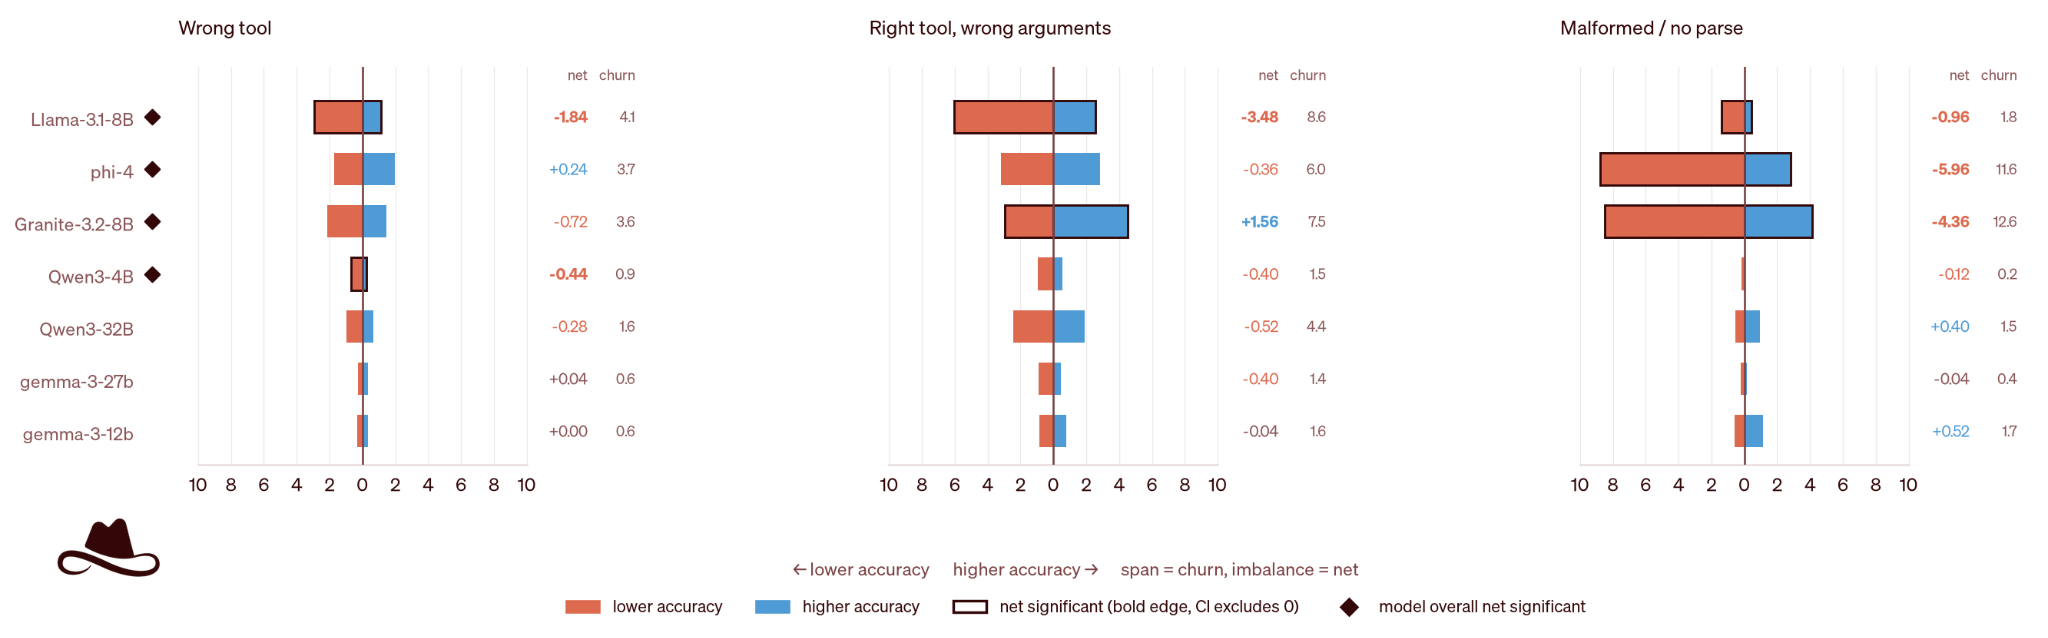


Исследовательница называет этот эффект sampling drift и пишут, что при нем изменения в семплировании начинают влиять не только на формулировки, но и на поведение модели. Так, в тестах маркировка контента влияла на отдельные вызовы инструментов и приводила к возникновению новых ошибок, хотя порой, напротив, исправляла некоторые прежние проблемы. Кроме того, поведение ИИ зависело от конкретного секретного ключа SynthID: разные ключи по-разному влияли на вероятность выполнения вредоносных инструкций.


При этом у исследования есть важные ограничения. В частности, Сипосова не тестировала Claude и не изучала реализацию SynthID-Text, которую будет использовать Anthropic. Эксперименты специально проводились на шести моделях с открытыми весами с использованием реализации tournament sampling из Hugging Face, чтобы можно было включать и отключать маркировку контента без изменения остальных настроек.


По словам исследовательницы, результаты этого исследования не означают, что водяные знаки делают модели небезопасными. Однако даже незаметное изменение в механизме генерации способно повлиять на защитные ограничения и действия ИИ-агентов. Сипосова рекомендует разработчикам отдельно проводить red team-тесты уже после включения SynthID, а не рассчитывать на то, что поведение модели останется прежним.

Исследовательница из компании Lasso Security обнаружила, что водяные знаки SynthID-Text могут влиять на безопасность больших языковых моделей. В некоторых случаях после включения маркировки контента LLM соглашались выполнять вредоносные инструкции, которые отклоняли без SynthID. Сильнее всего этот эффект проявился при атаках с использованием промпт-инжектов. Технология SynthID-Text была разработана специалистами Google, которые открыли ее исходный код. Вскоре ее планируют применять в моделях Claude, так как компания Anthropic внедряет маркировку ИИ-контента в связи с новым законодательством Евросоюза. По сути, SynthID-Text позволяет внедрить водяной знак в текст прямо в процессе его генерации. Обычно модель на каждом шаге выбирает следующий токен из нескольких подходящих вариантов с учетом их вероятностей. SynthID добавляет к этому процессу секретный ключ, который незаметно меняет приоритеты кандидатов: одни токены получают преимущество, а другие, наоборот, выбираются реже. К примеру, если модель может выбрать между словами вроде «облачно» и «пасмурно», секретный ключ может склонить ее ко второму варианту. В результате текст по-прежнему выглядит естественно, однако в последовательности выбранных токенов появляется скрытый паттерн. Зная секретный ключ, этот паттерн можно обнаружить и с определенной вероятностью установить, что текст был сгенерирован моделью с включенной маркировкой SynthID. Специалистка Lasso Security Андреа Сипосова (Andrea Siposova) проверила, влияет такое вмешательство только на формулировки в текстах или может дополнительно изменить поведение моделей. Для эксперимента она использовала немодифицированную версию SynthIDTextWatermarkLogitsProcessor из Hugging Face и шесть моделей с открытыми весами. В рамках опытов одни и те же вредоносные запросы отправлялись моделям с включенными водяными знаками и без них. Как оказалось, SynthID действительно меняет реакцию моделей на опасные инструкции. Разница была особенно выражена в сочетании с промпт-инжектами: после включения водяных знаков некоторые модели стали чаще отвечать на запросы, которые в обычном режиме отклоняли. Сипосова отмечает, что проблема затрагивает не только текстовые ответы. Если LLM используется в составе ИИ-агента, те же изменения в выборе токенов могут повлиять на то, какой инструмент в итоге вызовет агент и какие аргументы ему передаст. Исследовательница называет этот эффект sampling drift и пишут, что при нем изменения в семплировании начинают влиять не только на формулировки, но и на поведение модели. Так, в тестах маркировка контента влияла на отдельные вызовы инструментов и приводила к возникновению новых ошибок, хотя порой, напротив, исправляла некоторые прежние проблемы. Кроме того, поведение ИИ зависело от конкретного секретного ключа SynthID: разные ключи по-разному влияли на вероятность выполнения вредоносных инструкций. При этом у исследования есть важные ограничения. В частности, Сипосова не тестировала Claude и не изучала реализацию SynthID-Text, которую будет использовать Anthropic. Эксперименты специально проводились на шести моделях с открытыми весами с использованием реализации tournament sampling из Hugging Face, чтобы можно было включать и отключать маркировку контента без изменения остальных настроек. По словам исследовательницы, результаты этого исследования не означают, что водяные знаки делают модели небезопасными. Однако даже незаметное изменение в механизме генерации способно повлиять на защитные ограничения и действия ИИ-агентов. Сипосова рекомендует разработчикам отдельно проводить red team-тесты уже после включения SynthID, а не рассчитывать на то, что поведение модели останется прежним.
Цитирование статьи, картинки - фото скриншот - Rambler News Service.
Иллюстрация к статье - Яндекс. Картинки.
Есть вопросы. Напишите нам.
Общие правила  поведения на сайте.
CSS
запостил(а)
Evans
Вернуться назад

Смотрите также

А что там на главной? )))


Комментарии )))


Войти через: